Au-delà des benchmarks : comment LM Arena est devenu l'arbitre surprise de la guerre de l'IA
Dans le monde aux enjeux colossaux de l'intelligence artificielle, des milliards de dollars sont investis sur la base d'une seule question : quel est le meilleur modèle ? Pendant des années, la réponse a été recherchée à travers des…

Jean-Baptiste DuquesneSEO, GEO & content operations · Publié le 02 septembre 2025 · Mis à jour le 11 octobre 2026
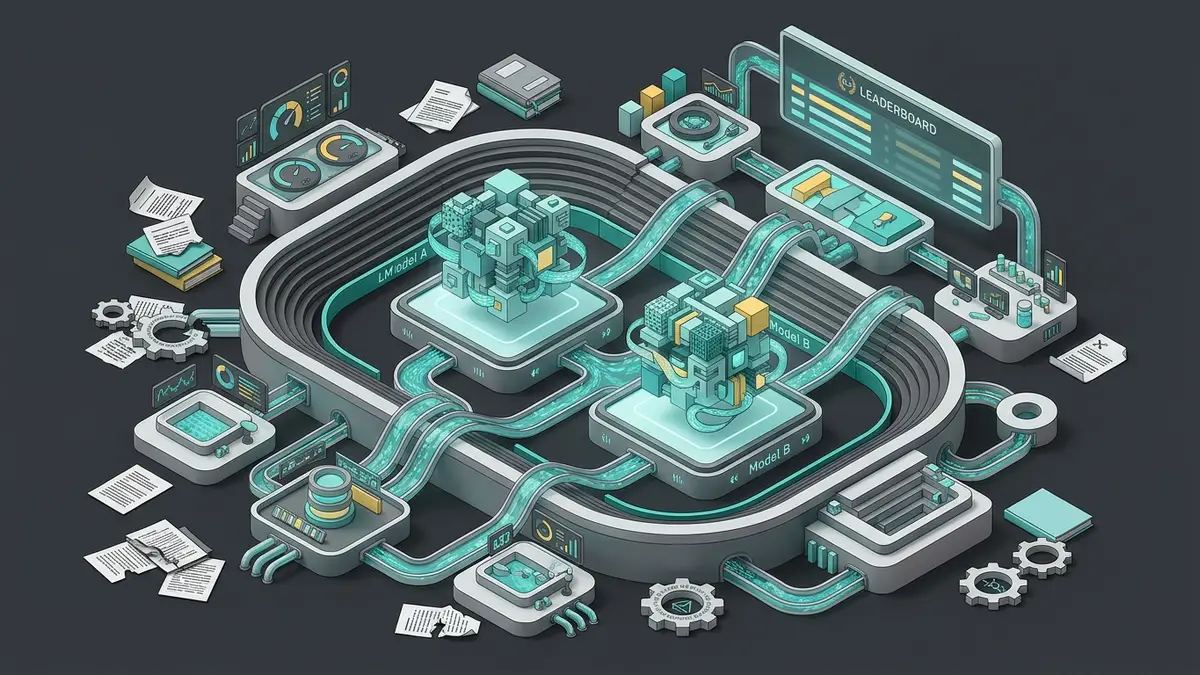
Dans le monde aux enjeux colossaux de l'intelligence artificielle, des milliards de dollars sont investis sur la base d'une seule question : quel est le meilleur modèle ? Pendant des années, la réponse a été recherchée à travers des benchmarks académiques standardisés, mais un fossé croissant est apparu entre ces scores et l'expérience utilisateur réelle. Un modèle peut exceller à des questions à choix multiples mais échouer en communication nuancée. C'est dans cette brèche qu'est apparue la Chatbot Arena, souvent appelée LM Arena. Gérée par LMSYS, cette plateforme repose sur une mesure intuitive : la préférence humaine. En opposant les modèles dans des batailles anonymes, LM Arena est devenu le champion de l'évaluation de l'IA.
Le problème des benchmarks d'IA traditionnels
Tromper le système : quand les métriques ne valent pas intelligence
Les benchmarks traditionnels fournissent un moyen standardisé de mesurer les capacités en mathématiques ou en codage. Cependant, ils souffrent du risque que les développeurs entraînent leurs modèles sur les questions du test, un phénomène de surajustement. Un modèle peut paraître brillant sur le papier mais sembler fragile en utilisation réelle, car il mémorise au lieu de raisonner.
Le fossé entre les scores quantitatifs et l'expérience qualitative
Les tests académiques ne capturent pas le ton ou la créativité d'un chatbot. L'industrie avait besoin de mesurer ce que l'on ressent en utilisant l'outil. Par exemple, l'usage de GPT-4o dans ChatGPT a montré que la fluidité conversationnelle prime souvent sur les scores bruts. Cette nuance est essentielle lorsqu'il s'agit de traduction et adaptation de campagnes marketing, où l'élégance du style importe autant que la précision. Les entreprises cherchent aujourd'hui des solutions capables de suivre des instructions complexes de manière engageante, dépassant la simple exécution technique.
La solution LM Arena : un colisée pour chatbots
Le génie de la compétition aveugle en face à face
La méthodologie de LM Arena est simple : deux chatbots anonymes répondent à la même question. L'utilisateur vote pour la meilleure réponse sans connaître l'identité de l'IA, ce qui élimine les biais de marque. Qu'il s'agisse de tester un modèle propriétaire récent ou un modèle open-source, seul le mérite de la réponse compte. Cette approche permet d'évaluer objectivement l'efficacité d'un modèle rapide et réactif face à des géants établis.
Le système de classement Elo : une mesure robuste
LMSYS utilise le système Elo pour classer les modèles. Cette méthode statistique calcule les niveaux de compétence relatifs. Ce classement reflète la puissance perçue dans des interactions réelles. Pour les entreprises, c'est une mine d'or d'informations avant d'investir dans une API IA pour leurs services. C'est devenu l'une des métriques les plus suivies pour valider la performance concrète des LLM.
L'impact du classement du peuple sur l'industrie
Un arbitre impartial face au marketing
Lorsqu'une entreprise affirme que son modèle est révolutionnaire, la communauté vérifie immédiatement ses performances sur l'Arena. C'est un filtre essentiel contre le bruit publicitaire. Pour les équipes marketing, cela aide à choisir entre des modèles légers et des alternatives plus lourdes. Le classement devient un révélateur de vérité indispensable pour les décideurs.
Stimuler l'innovation et façonner le marché
Le succès sur LM Arena valide les modèles open-source. Cela encourage les développeurs à se concentrer sur l'utilité réelle tout en s'appuyant sur les percées technologiques majeures. On observe en effet comment la recherche de Google DeepMind continue de repousser les limites des architectures neuronales, forçant les entreprises à privilégier l'expérience utilisateur globale plutôt que l'intelligence brute.
Cas d'usage et bonnes pratiques pour les entreprises
Pour exploiter au mieux ces classements, les entreprises doivent tester plusieurs modèles selon leurs besoins spécifiques. Utiliser un grand modèle de langage pour la rédaction complexe tout en s'appuyant sur l'apprentissage supervisé pour des tâches précises est une stratégie gagnante. Enfin, intégrer l'IA dans des flux de travail existants, comme avec l'intégration de ChatGPT dans Outlook, permet de gagner en productivité.
Gouvernance et éthique dans l'évaluation de l'IA
L'évaluation par les humains soulève aussi des questions sur la sécurité. Les cas de fuite de données rappellent l'importance de la protection des informations. De même, il faut rester vigilant face au biais dans l'IA, car la préférence humaine peut parfois refléter des préjugés sociétaux. Pour que l'implémentation de ces outils soit un succès, il est impératif de considérer l’IA comme un enjeu organisationnel global, l'arbitrage de LM Arena devant être complété par une gouvernance d'entreprise rigoureuse.
Optimiser votre production de contenu avec Brandeploy
Le classement de LM Arena identifie les meilleurs modèles, mais Brandeploy permet de les rendre réellement opérationnels pour votre entreprise. Notre plateforme est agnostique : vous pouvez utiliser le modèle le mieux classé du moment tout en garantissant que le résultat respecte scrupuleusement l'identité de votre marque. En centralisant vos actifs dans un DAM sécurisé, vous évitez la fragmentation et assurez une cohérence parfaite sur tous vos canaux. Découvrez comment l'automatisation créative par IA de Brandeploy produit à grande échelle bannières, vidéos et visuels conformes à la marque. Pour transformer ces innovations technologiques en performances business concrètes, réservez votre démo.
FAQ
Qu'est-ce que LM Arena et pourquoi est-ce important pour l'IA ?
LM Arena (ou Chatbot Arena) est une plateforme d'évaluation participative gérée par LMSYS. Elle utilise un système de comparaison en aveugle où des utilisateurs testent deux modèles d'IA anonymes et votent pour la meilleure réponse. C'est l'arbitre le plus fidèle de la qualité réelle des LLM.
Comment fonctionne le système de classement Elo dans la Chatbot Arena ?
Le score Elo, issu du monde des échecs, calcule le niveau de compétence relatif des modèles d'IA. Dans la LM Arena, ce score évolue selon les victoires ou défaites contre d'autres IA. Il permet d'établir un classement dynamique basé sur la préférence humaine statistique.
Pourquoi les benchmarks traditionnels comme MMLU sont-ils critiqués ?
Les benchmarks classiques comme MMLU sont limités car les modèles peuvent être entraînés spécifiquement pour y répondre (surajustement). Contrairement à ces tests statiques, LM Arena mesure l'expérience utilisateur et la capacité de l'IA à gérer des requêtes imprévisibles et nuancées.
Quel est l'avantage de la préférence humaine sur les tests automatisés ?
L'évaluation humaine capture des subtilités que les algorithmes ignorent : le ton, la créativité, la pertinence contextuelle et la politesse. Un modèle peut avoir un score technique élevé mais être désagréable à utiliser. La préférence humaine garantit que l'IA est réellement utile et performante au quotidien.
Les modèles d'IA open source peuvent-ils rivaliser avec les modèles propriétaires ?
Oui, les modèles open source comme Mistral ou Llama rivalisent souvent avec GPT-4 dans le classement. Cette transparence permet aux développeurs de prouver leur valeur sans budget marketing massif, favorisant une innovation ouverte et une saine compétition technologique.
Écrit par
Jean-Baptiste Duquesne
SEO, GEO & content operations
Pionnier du web depuis 1995, fondateur du site de recettes 750g.com (revendu à Webedia), il industrialise aujourd'hui la production de contenus SEO et GEO avec l'IA.
Prêt à passer votre production de contenus à l'échelle ?
Réservez une démo